Średnia jest jak zdjęcie zrobione z dużej odległości. Widać na nim, gdzie stoi tłum, ale nie widać, co robią poszczególni ludzie. Kto przepycha się do przodu, kto stoi na palcach, a kogo w ogóle nie wpuszczono.
Histogram robi zdjęcie z bliska. I wtedy dane zaczynają opowiadać historie. O egzaminatorach z miękkim sercem, o mężczyznach, którym brakuje centymetra do szczęścia, i o biegaczach, którzy na ostatnich kilometrach walczą bardziej z zegarkiem niż z dystansem.
Wybrałem siedem takich historii. Część z nich pokazaliśmy w karuzeli dla społeczności I❤️DATA. Tutaj opowiem je spokojniej i przy każdej zatrzymam się na chwilę, żeby zapytać: co z tego wynika dla analityka?
A jeśli histogram to dla Ciebie pojęcie trochę zakurzone, zacznij od wpisu Jak utworzyć histogram w Excelu.
1. Matura, czyli egzaminatorzy są zawsze obiektywni
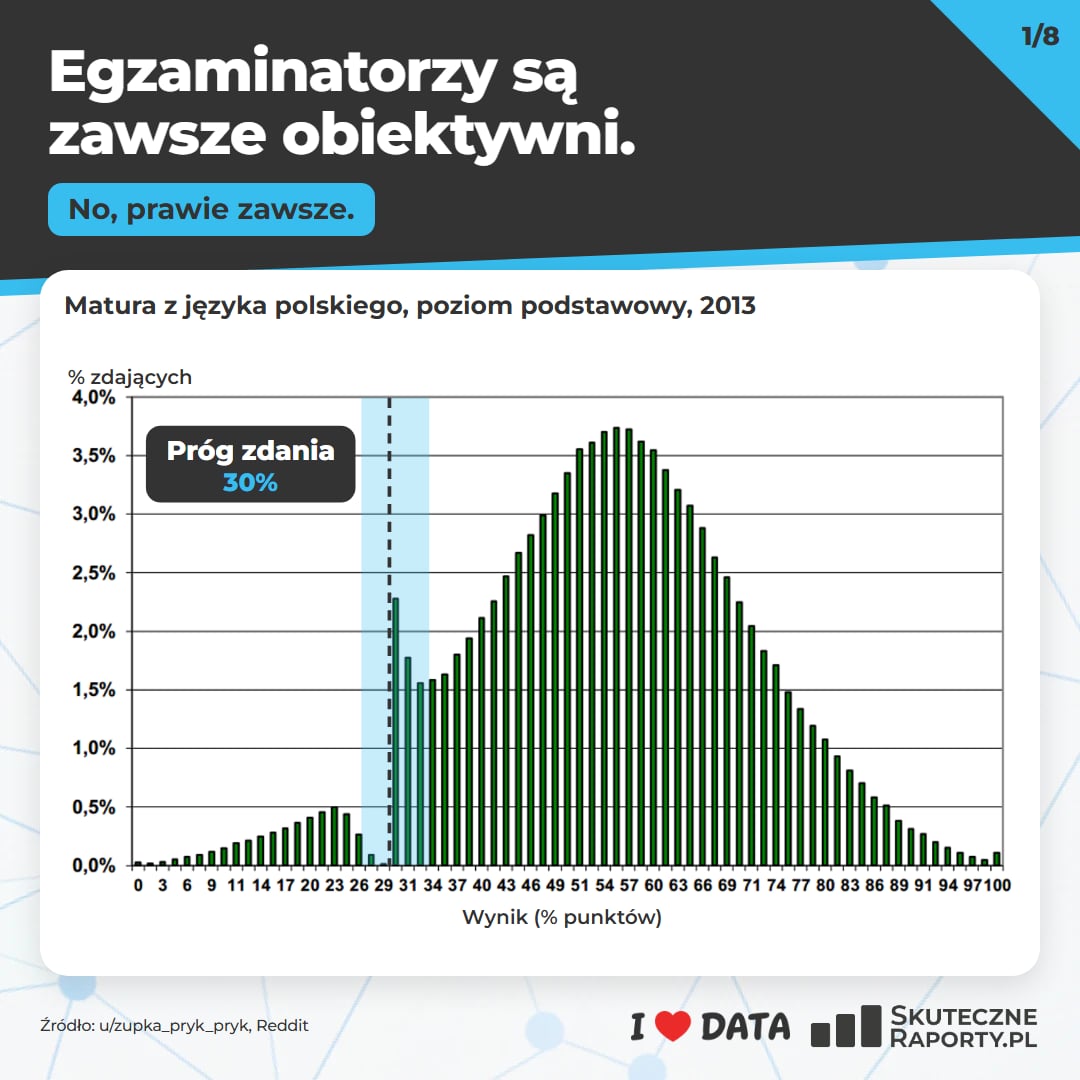
Zacznijmy od wykresu, który zna wielu nauczycieli. To wyniki matury z języka polskiego na poziomie podstawowym z 2013 roku. Na osi poziomej jest wynik w procentach, na pionowej odsetek zdających.
Na pierwszy rzut oka wszystko wygląda porządnie: łagodna górka ze szczytem w okolicy 55%, jak z podręcznika. Ale wystarczy spojrzeć w lewo. Tuż przed progiem zdania, przy wynikach 27–29%, słupki niemal znikają. Jakby nikt nie pisał matury odrobinę za słabo. A zaraz za progiem, przy 30%, wyrasta słupek wyraźnie wyższy od sąsiadów.
Wykres nie mówi, co działo się przy biurkach egzaminatorów. Mówi tylko jedno: w tym miejscu rozkład przestaje być naturalny. Łatwo jednak wyobrazić sobie pracę, której brakuje jednego punktu, i człowieka, który szuka go jeszcze raz, trochę uważniej niż zwykle.
Lekcja dla analityka: tam, gdzie jest próg, jest też pokusa. Progi premii, limity rabatów, granice akceptacji wniosków potrafią zostawić w danych dokładnie taki sam ślad. Wystarczy zrobić histogram w wąskich przedziałach i spojrzeć na okolicę progu.
2. Brakujące centymetry
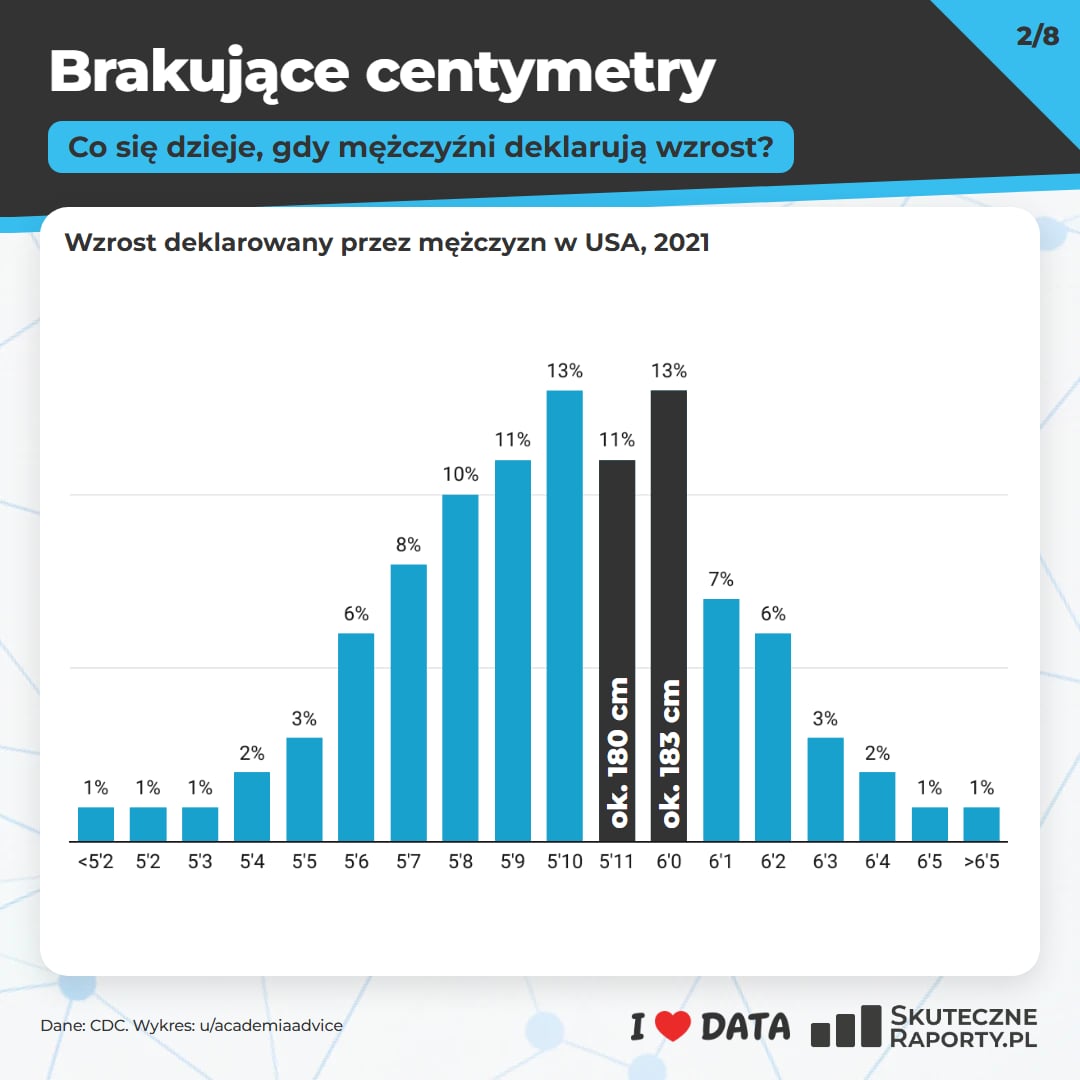
Ten wykres pochodzi z USA z 2021 roku. Mężczyźni sami podawali swój wzrost, tradycyjnie w stopach i calach. Najwięcej odpowiedzi to 5’10” i 6’0″, po 13%. A pomiędzy nimi, przy 5’11” (około 180 cm), pojawia się dziwne wgłębienie: tylko 11%.
Natura nie robi takich ząbków. Robią je ludzie. Sześć stóp to w Ameryce magiczna granica, mniej więcej jak u nas okrągłe 180 centymetrów. Kiedy brakuje do niej tak niewiele, część panów po prostu… dodaje sobie ten jeden cal. W ankiecie nikt przecież nie mierzy.
Lekcja dla analityka: dane deklarowane to nie to samo co dane zmierzone. Ludzie zaokrąglają i lekko poprawiają odpowiedzi w stronę wartości, które lepiej brzmią. Zjawisko ma nawet swoją angielską nazwę: heaping, czyli zbijanie się odpowiedzi przy okrągłych liczbach. Spotkasz je w ankietach, formularzach i wszędzie tam, gdzie wartość wpisuje człowiek, a nie urządzenie.
3. Rozkład normalny nie istnieje… aż pójdziesz na siłownię
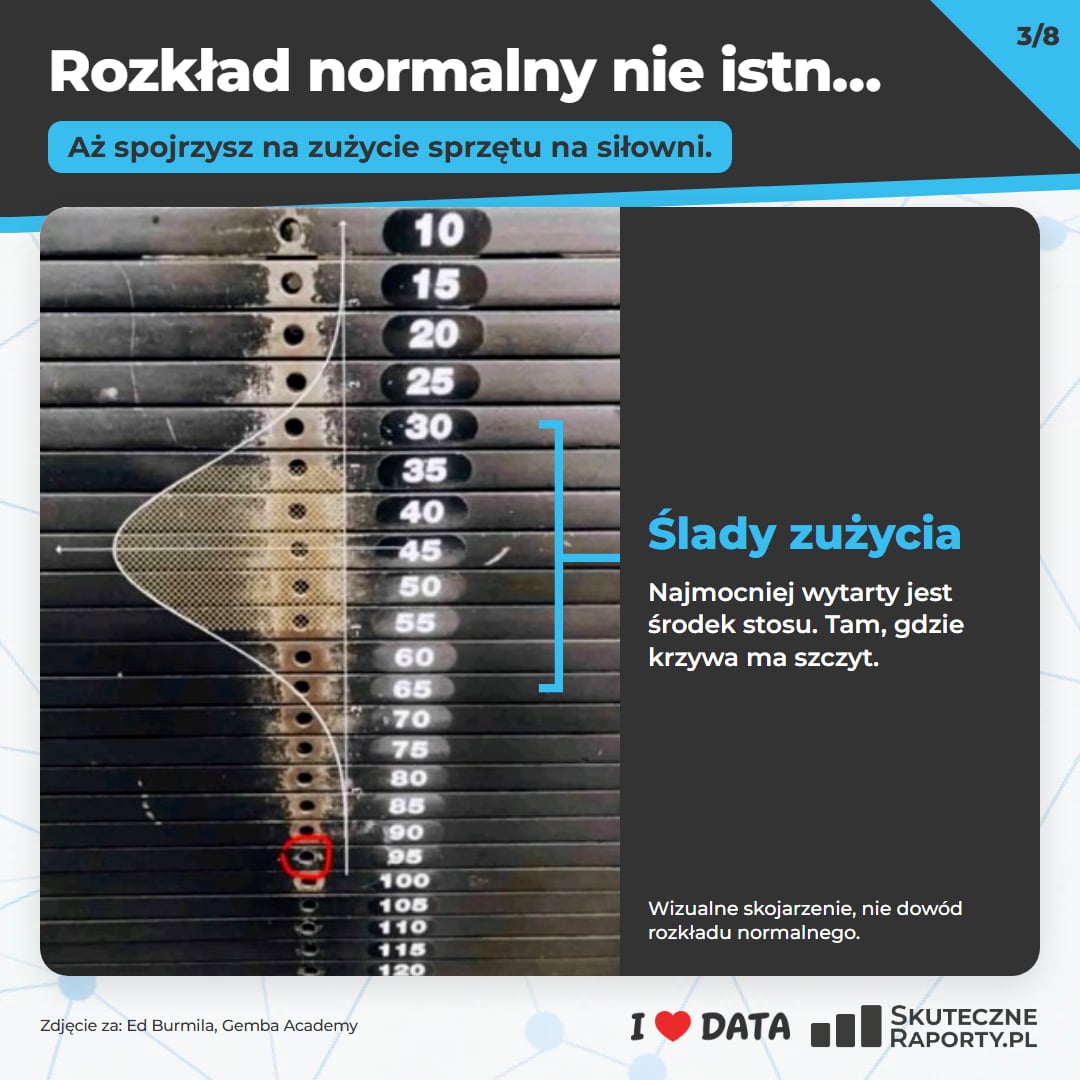
Ten przykład nie jest wykresem. To zwykłe zdjęcie stosu ciężarków na maszynie do ćwiczeń. Płytki na samej górze i na samym dole są niemal nietknięte. Najmocniej wytarty jest środek, w okolicy 40–55. Ktoś dorysował na zdjęciu krzywą i nagle stara, zniszczona maszyna wygląda jak ilustracja z podręcznika statystyki.
Uczciwie trzeba dodać, że to tylko wizualne skojarzenie, a nie dowód na rozkład normalny. Ale jakie wymowne! Każdy, kto kiedykolwiek ćwiczył na takiej maszynie, dołożył do tej krzywej swoją cegiełkę.
Lekcja dla analityka: rozkład nie zawsze mieszka w tabeli. Wytarte przyciski, wydeptane ścieżki na trawniku, najczęściej klikane pozycje w menu to też histogramy. Rysują je użytkownicy, nawet o tym nie wiedząc.
4. Byle nie cztery godziny!
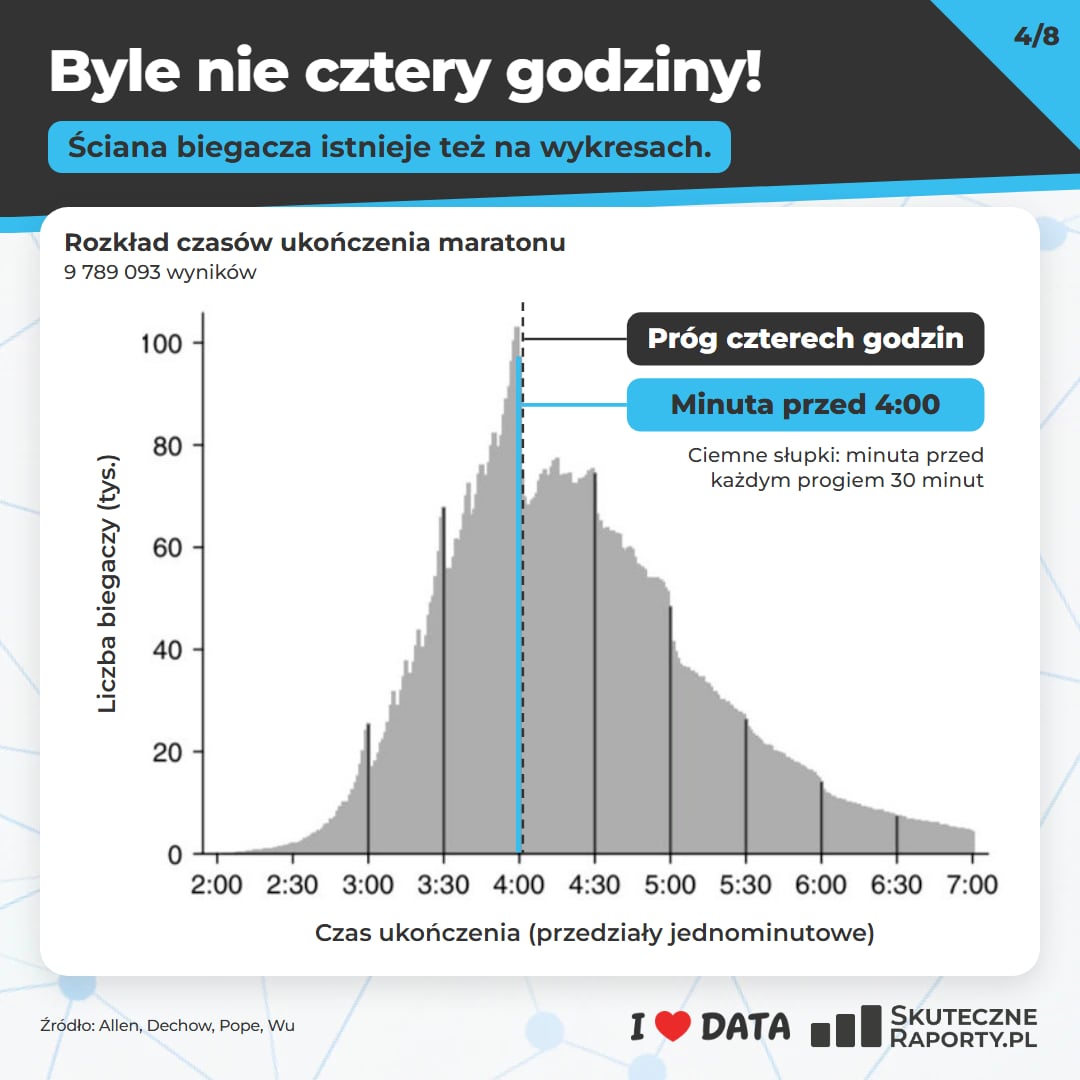
Biegacze mówią o „ścianie”, na którą wpada się około trzydziestego kilometra. Ten histogram pokazuje inną ścianę, zbudowaną nie z mięśni, tylko z ambicji. To czasy ukończenia maratonu prawie 9,8 miliona biegaczy, w przedziałach jednominutowych. Źródłem są badania Allena, Dechowa, Pope’a i Wu.
Gdyby ludzie biegli, nie patrząc na zegarek, wykres byłby gładki jak zbocze góry. Tymczasem tuż przed każdym okrągłym czasem (3:00, 3:30, 4:00, 4:30) wyrastają wyraźnie wyższe słupki. Najwyższy jest tuż przed progiem czterech godzin. Kto widzi, że może złamać „czwórkę”, wyciska z siebie ostatnie siły. Kto wie, że już nie zdąży, zwalnia.
Lekcja dla analityka: ludzie reagują na cele i okrągłe liczby. Jeśli w firmie obowiązuje cel „100 rozmów w miesiącu” albo „czas obsługi poniżej 5 minut”, histogram bardzo często pokaże tłok tuż przed tą granicą. Nie musi to oznaczać nieuczciwości. Może oznaczać, że ludzie grają pod wskaźnik, a nie pod cel, któremu ten wskaźnik miał służyć.
5. Czy dzieci wolą rodzić się rano?
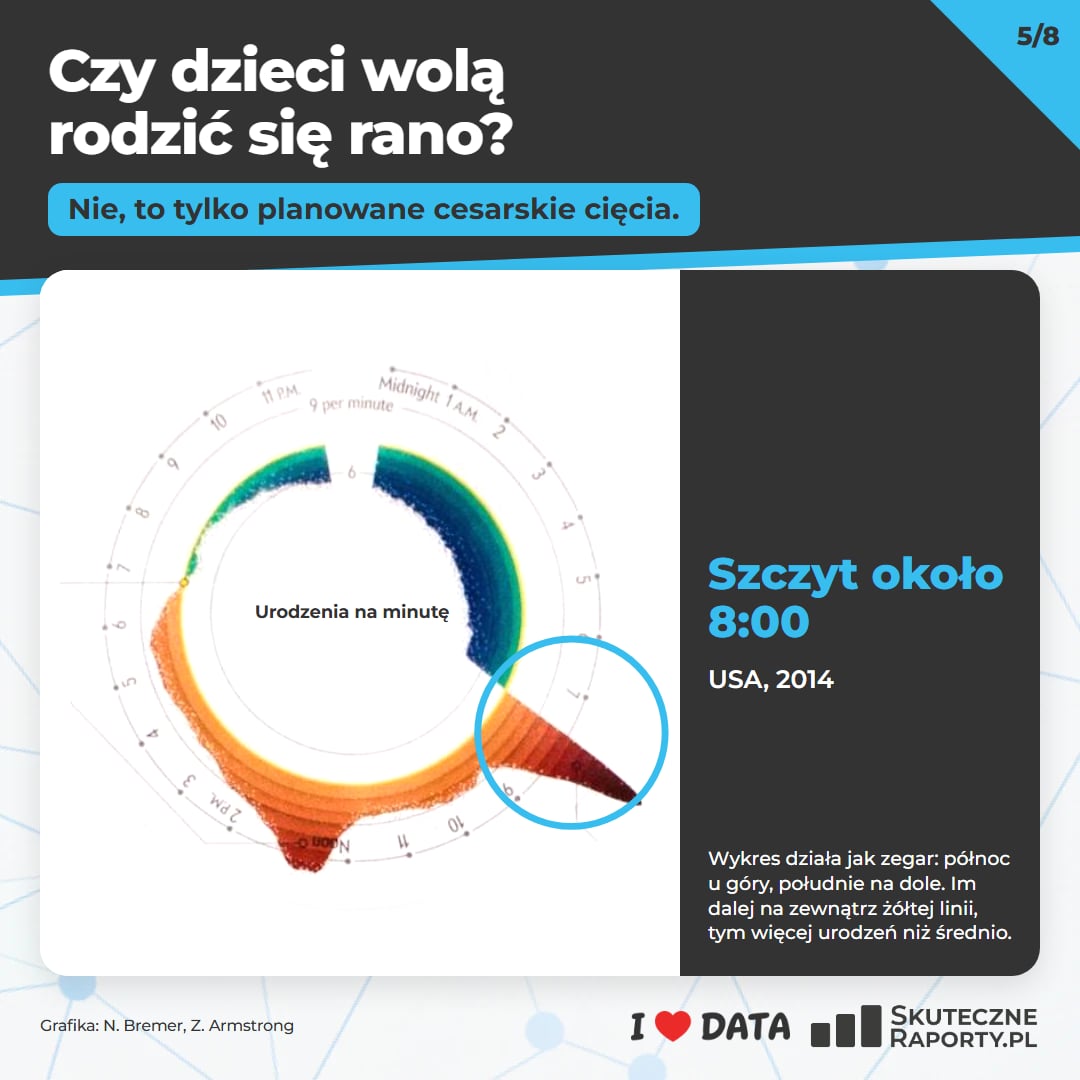
Ten wykres jest wyjątkowo piękny i wyjątkowo podchwytliwy. Pokazuje liczbę urodzeń w ciągu doby w USA w 2014 roku, ułożoną na tarczy zegara: północ u góry, południe na dole. Im dalej od żółtej linii na zewnątrz, tym więcej urodzeń niż średnio. Autorkami grafiki są Nadieh Bremer i Zan Armstrong.
Najwyraźniejszy szczyt przypada około ósmej rano. Czyżby noworodki były rannymi ptaszkami? Nie. To szpitale. Na poranne godziny planuje się cesarskie cięcia i indukcje porodu, więc kalendarz oddziału zostawia na wykresie wyraźny ślad.
Lekcja dla analityka: zanim zinterpretujesz rozkład w czasie, sprawdź, co w procesie jest zaplanowane, a co spontaniczne. Szczyt zamówień o 9:00 może być efektem automatycznego importu, a nie zachowań klientów. Fala zgłoszeń w poniedziałek może wynikać z weekendu, a nie z awarii produktu.
6. Piramida, która straciła podstawę
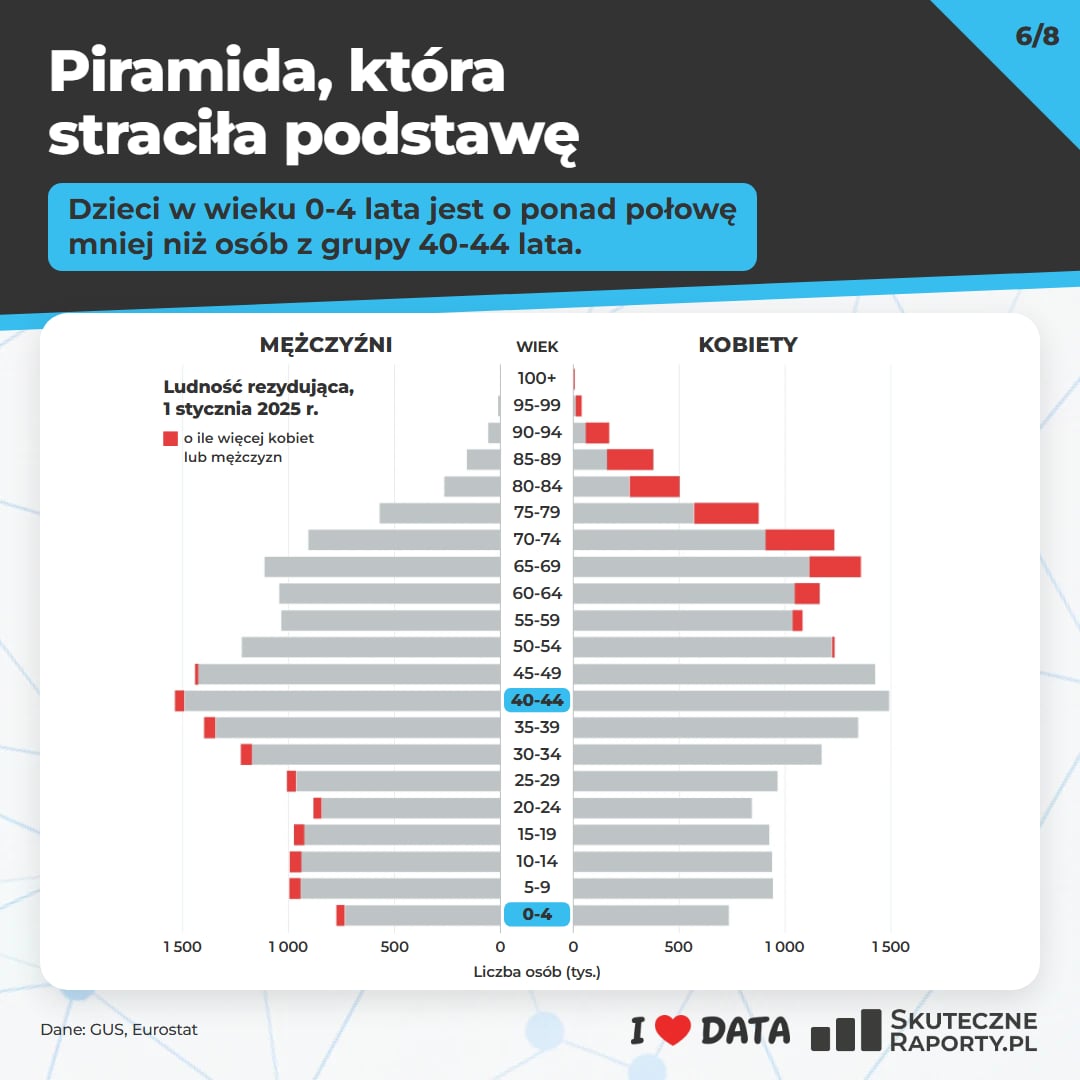
Piramida wieku to w gruncie rzeczy dwa histogramy obrócone na bok i ustawione plecami do siebie: mężczyźni po lewej, kobiety po prawej. Ta pokazuje ludność Polski na 1 stycznia 2025 roku w przedziałach pięcioletnich, na podstawie danych GUS i Eurostatu.
Klasyczna piramida, ta z podręczników geografii, stoi na szerokiej podstawie, bo najliczniejsze są dzieci. Nasza wygląda raczej jak wazon. Najszerzej jest w grupie 40–44 lata, a dzieci w wieku 0–4 lata jest mniej więcej o połowę mniej. Czerwone fragmenty dopowiadają drugą historię: w młodszych rocznikach jest trochę więcej mężczyzn, ale mniej więcej od pięćdziesiątki przewaga kobiet rośnie z każdą dekadą.
Lekcja dla analityka: dwa histogramy ustawione naprzeciw siebie to jeden z najczytelniejszych sposobów porównania rozkładów. Ten sam układ świetnie sprawdzi się przy porównaniu dwóch lat, dwóch regionów albo dwóch segmentów klientów.
7. Gdzie dołożyć pancerz?
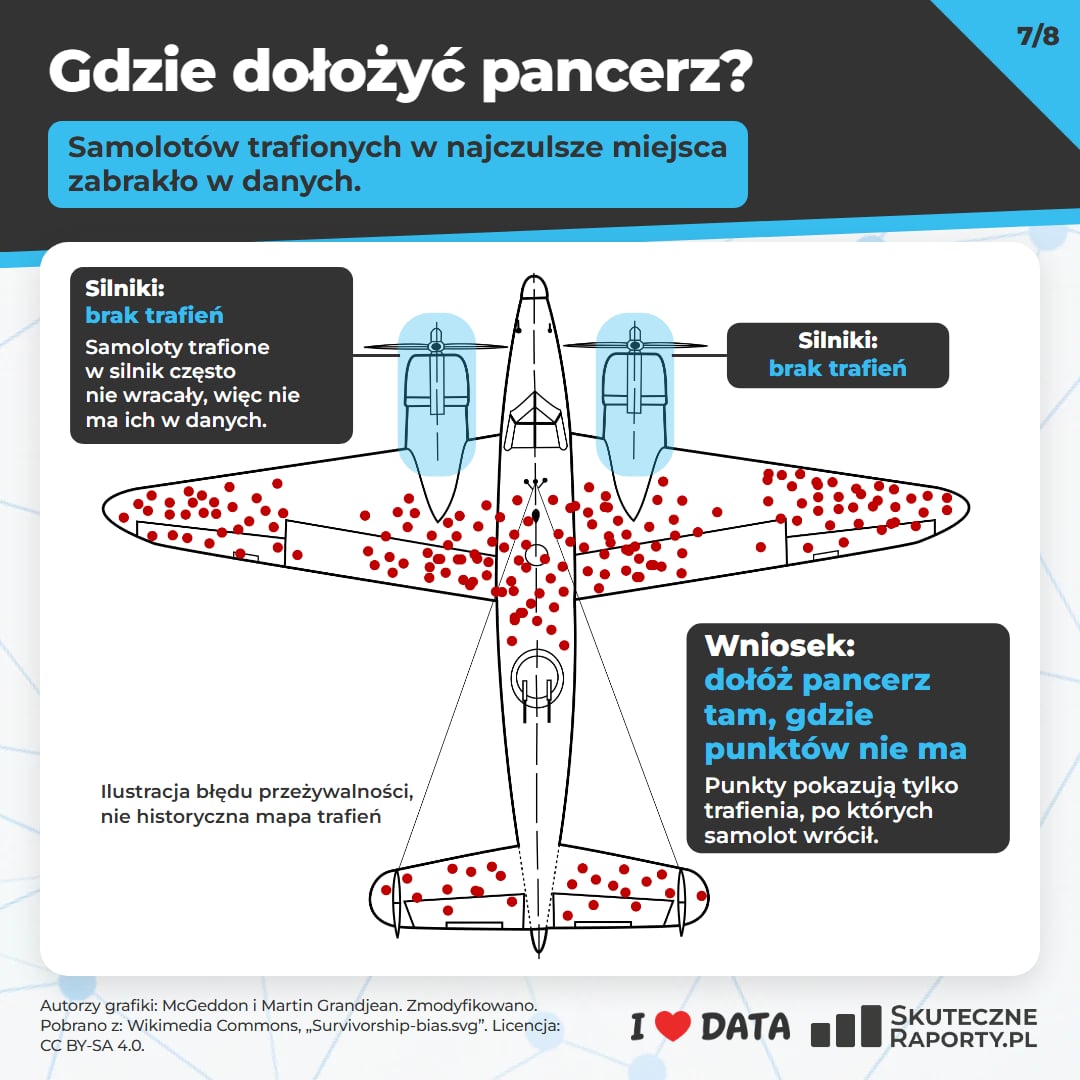
Na koniec historia, którą powinien znać każdy, kto pracuje z danymi. Czerwone punkty pokazują miejsca trafień na samolotach, które wróciły z misji. Najwięcej jest ich na skrzydłach i kadłubie. Na silnikach prawie żadnych.
Odruch podpowiada: wzmocnijmy miejsca, w które trafia się najczęściej. I to jest dokładnie ten błąd, przed którym ostrzega ta grafika. Samoloty trafione w silnik zwykle nie wracały. Nie ma ich na wykresie, bo leżą gdzieś na dnie morza. Pancerz trzeba więc dołożyć tam, gdzie punktów nie ma.
Tę historię zwykle łączy się ze statystykiem Abrahamem Waldem i jego pracą w czasie II wojny światowej. Sama grafika jest ilustracją zjawiska, a nie historyczną mapą trafień. Zjawisko nazywa się błędem przeżywalności.
Lekcja dla analityka: zanim wyciągniesz wniosek, zapytaj, kogo brakuje w danych. Ankieta satysfakcji wysłana tylko do obecnych klientów nie powie, dlaczego odeszli ci, których już nie ma. Analiza „udanych” projektów milczy o tych, które zamknięto po drodze.
Jak znaleźć takie historie we własnych danych?
Ciekawe histogramy rzadko pojawiają się przypadkiem. Zwykle trzeba im trochę pomóc. Oto kilka nawyków, które bardzo w tym pomagają:
- Zawężaj przedziały. Przy szerokich przedziałach luka przed progiem matury i ząbek przy 5’11” rozmyłyby się bez śladu. Zacznij od przedziału równego jednostce danych: 1 punkt, 1 centymetr, 1 minuta.
- Rysuj progi i cele na wykresie. Jedna linia na progu zdania, limicie rabatu czy celu sprzedażowym od razu pokaże, czy wyniki tłoczą się tuż przed nią albo tuż za nią.
- Patrz na okrągłe liczby. Jeśli dane wpisuje człowiek, szukaj skupisk przy 5, 10, 50 i 100.
- Pytaj, kogo brakuje. Pusta część histogramu może oznaczać, że takich przypadków nie ma. Ale może też oznaczać, że nie trafiły do danych.
- Zestaw histogram z wykresem gęstości. Wykres gęstości pięknie porównuje kształty rozkładów, ale wygładza skoki, które na histogramie widać od razu. Najlepiej oglądać oba wykresy razem. Jak zbudować go w Excelu i Power BI, pokazuję we wpisie Wykres gęstości w Excelu i Power BI.
Sam histogram zrobisz w Excelu na dwa sposoby. Pierwszy to wbudowany wykres, opisany we wpisie Jak wstawić wykres typu histogram w Excelu 2016 i 365. Drugi to tabela przestawna, jak w artykule Histogram na wykresie przestawnym.
Na koniec
Każdy z tych wykresów pokazuje coś, czego nie zdradziłaby żadna średnia. Ludzi, którzy zaokrąglają. Ludzi, którzy walczą o próg. Szpitale, które układają grafik. I dane, w których brakuje najważniejszych przypadków.
Dobry analityk nie zatrzymuje się na jednej liczbie. Patrzy na rozkład, szuka miejsc, które nie pasują, i zadaje proste pytanie: skąd to się wzięło?
Takie przykłady, wyzwania na prawdziwych danych i spotkania z ekspertami regularnie omawiamy w programie I❤️DATA. Jeśli lubisz szukać historii w danych, to miejsce dla Ciebie.
Najczęstsze pytania
Co to jest histogram?
To wykres, który dzieli wartości na przedziały i pokazuje, ile obserwacji wpada do każdego z nich. Dzięki temu widać kształt rozkładu: gdzie jest najwięcej danych, czy rozkład jest symetryczny i czy pojawiają się nietypowe skoki albo luki.
Jaką szerokość przedziału wybrać?
Jeśli szukasz anomalii, wybieraj wąskie przedziały, najlepiej równe jednostce danych. Jeśli chcesz pokazać ogólny kształt, lepiej sprawdzą się szersze. Warto przetestować kilka ustawień, bo wygląd histogramu mocno od nich zależy.
Czym różni się histogram od wykresu gęstości?
Histogram pokazuje słupki w przedziałach, więc dobrze widać na nim skoki i luki. Wykres gęstości pokazuje wygładzoną krzywą. Łatwiej na nim porównać kilka grup, ale drobne anomalie mogą zniknąć.
Co to jest błąd przeżywalności?
To błąd polegający na wyciąganiu wniosków tylko z przypadków, które „przetrwały” jakiś proces. Pozostałe, często najważniejsze, w ogóle nie trafiają do danych.